这是一个值得关注的漏洞
来源:牧之野
有读者向我反映一个问题。
我觉得很重要。
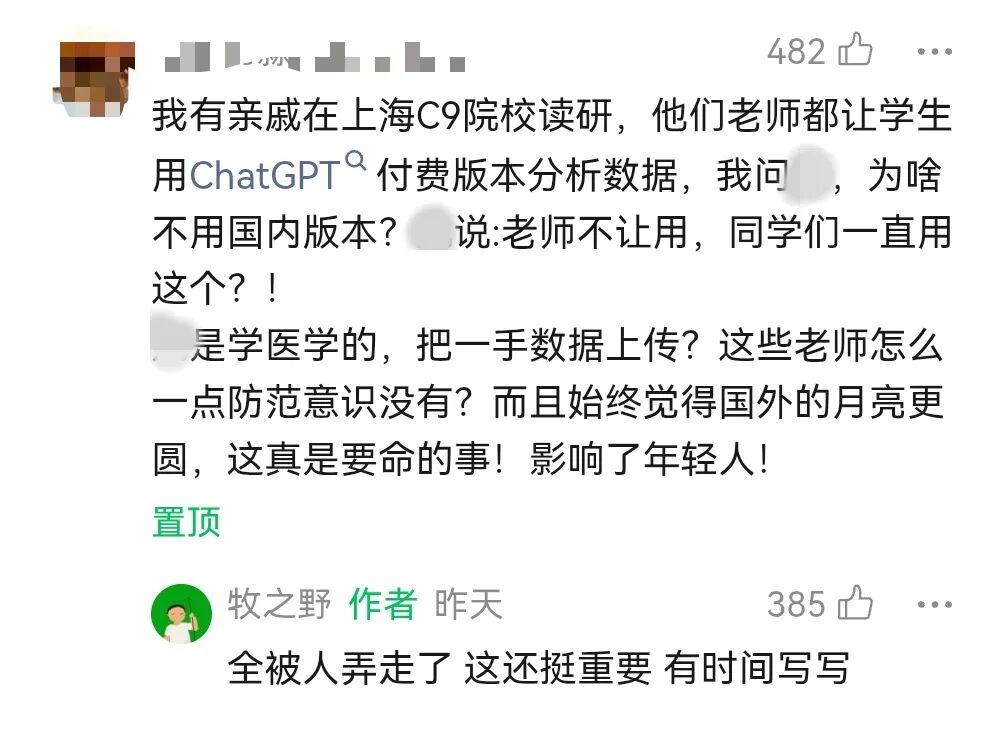
为了验证相关信息,我这两天重点在科技群、医生群做调研,也找了一些专家朋友了解情况。
重点是关于:
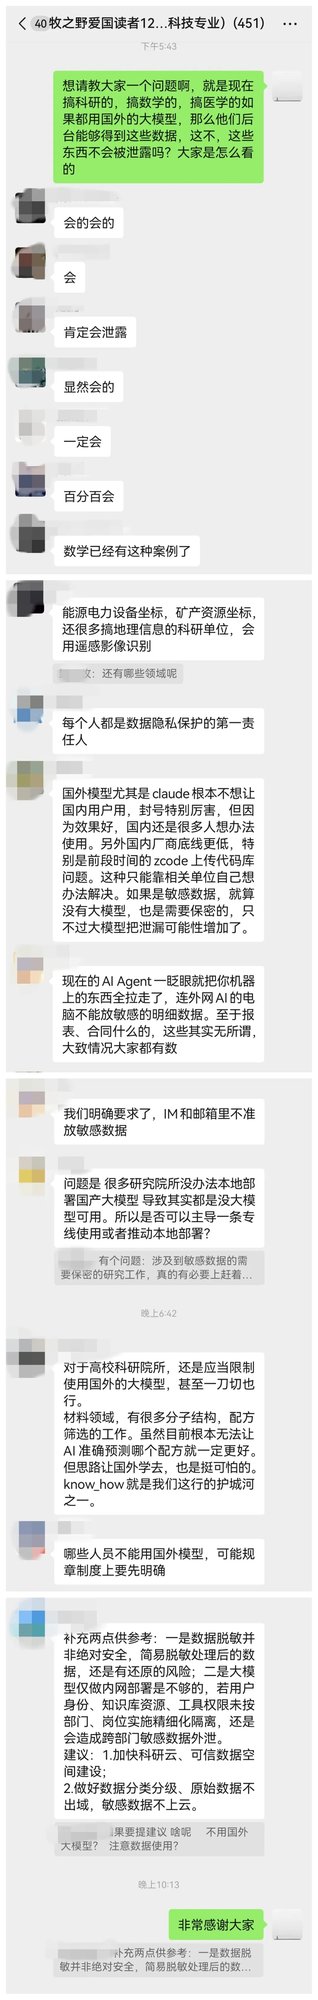
1.如果使用国外大模型,是否存在科研信息数据(非严格涉密内容)被后台盗窃的可能
2.在医学领域,这或许是个常态,那么在其它研究领域呢?
科技群不少读者都是专门从事Ai相关工作的,而医生更了解内部的情况。
从各方得到的消息,基本可以确定,这不是个别现象。
其实从上次AI解决数学猜想开始,就出现类似问题——
AI大模型是可以窃取你科研成果的。
美国纽约大学的数学家特里斯坦·巴克马斯特,和他的合作者莱文特·阿尔波格,花了一年时间,沿着西班牙数学家的思路,在流体力学最核心的纳维-斯托克斯方程上取得关键突破。这个方程已经困扰人类近百年——它描述的是水怎么流、风怎么吹、飞机翅膀上方的气流会不会突然断裂。克雷数学研究所为它悬赏了一百万美元,和另外六道难题一起,被称为“千禧年大奖难题”。
巴克马斯特团队借助AI工具Codex进行探索,这本是数学家们越来越熟悉的日常工作:把一部分重复性推理交给机器,人类专注于更宏观的方向判断。但问题出在一个谁都没想到的地方。
9月1日,OpenAI听到一则传闻——有人在纳维-斯托克斯方程上取得了进展。当天,他们启动了一个内部项目,把一个尚在训练中的先进模型,铺向全部六道未解难题。人类研究员随即介入,把算力全部调来,并发智能体从约100个扩到约1万个。这群AI智能体在88小时内交换了近500万条消息,消耗了相当于100万本书容量的token,最终给出了一份166页的证明。9月8日,OpenAI高调官宣:我们解决了纳维-斯托克斯方程。
巴克马斯特在同一天发表了措辞克制的公开声明。他说,OpenAI所用的技术路线,和自己团队研究了一年的方向高度相似。他推测,OpenAI可能是从某种渠道了解到他们的进展后紧急加码的。随后披露的更多细节让事件变得更加微妙:OpenAI的研究员塞巴斯蒂安·布贝克曾向巴克马斯特提出两个解决方案——要么协调发布,巴克马斯特和阿尔波格先发他们研究的三个方程的爆破结果,OpenAI随后发纳维-斯托克斯的主论文;要么巴克马斯特独自撰写论文并致谢OpenAI,但需要在作者名单中移除阿尔波格,理由是他在Anthropic工作这件事“太烦人了”。
OpenAI随后发布声明,称自己在对方发布成果前没有看到任何具体内容,但“不能排除他们的数据匿名化后被用来训练我们模型的可能性”。这句话翻译过来就是:虽然我们不会直接调取某个用户的对话记录,但你和AI讨论问题时的思路、方向、方法,可能在去除身份信息后进入了模型的训练管线。
一个数学家花了整整一年的思考,可能就这样,变成了喂养另一个系统的养料。【作者 阿简呀jane】
现在,我们国家在涉密相关研究上有明确规定,不允许用国外模型。
但,对于徘徊在涉密不涉密边缘的这些基础信息数据,或者没有办法现在就定好密的数据,对于这些还没有产出成果的科研,一些没有考虑到的领域,管不了那么多。
可这同样是一个国家最顶尖的信息啊。
一点点看不出来,连成线片,很多分析就出来了。
日本搜集情报能力是世界级水平,侵华战争之前,他们派了很多间谍到中国,把每一处村庄,每一条河流,每一口水井都绘制在地图上。
但现在,都不用了,美国坐在家里收偷窥就好了,打包发给盟友。
不能说没确切规定,这样做就是合理的。
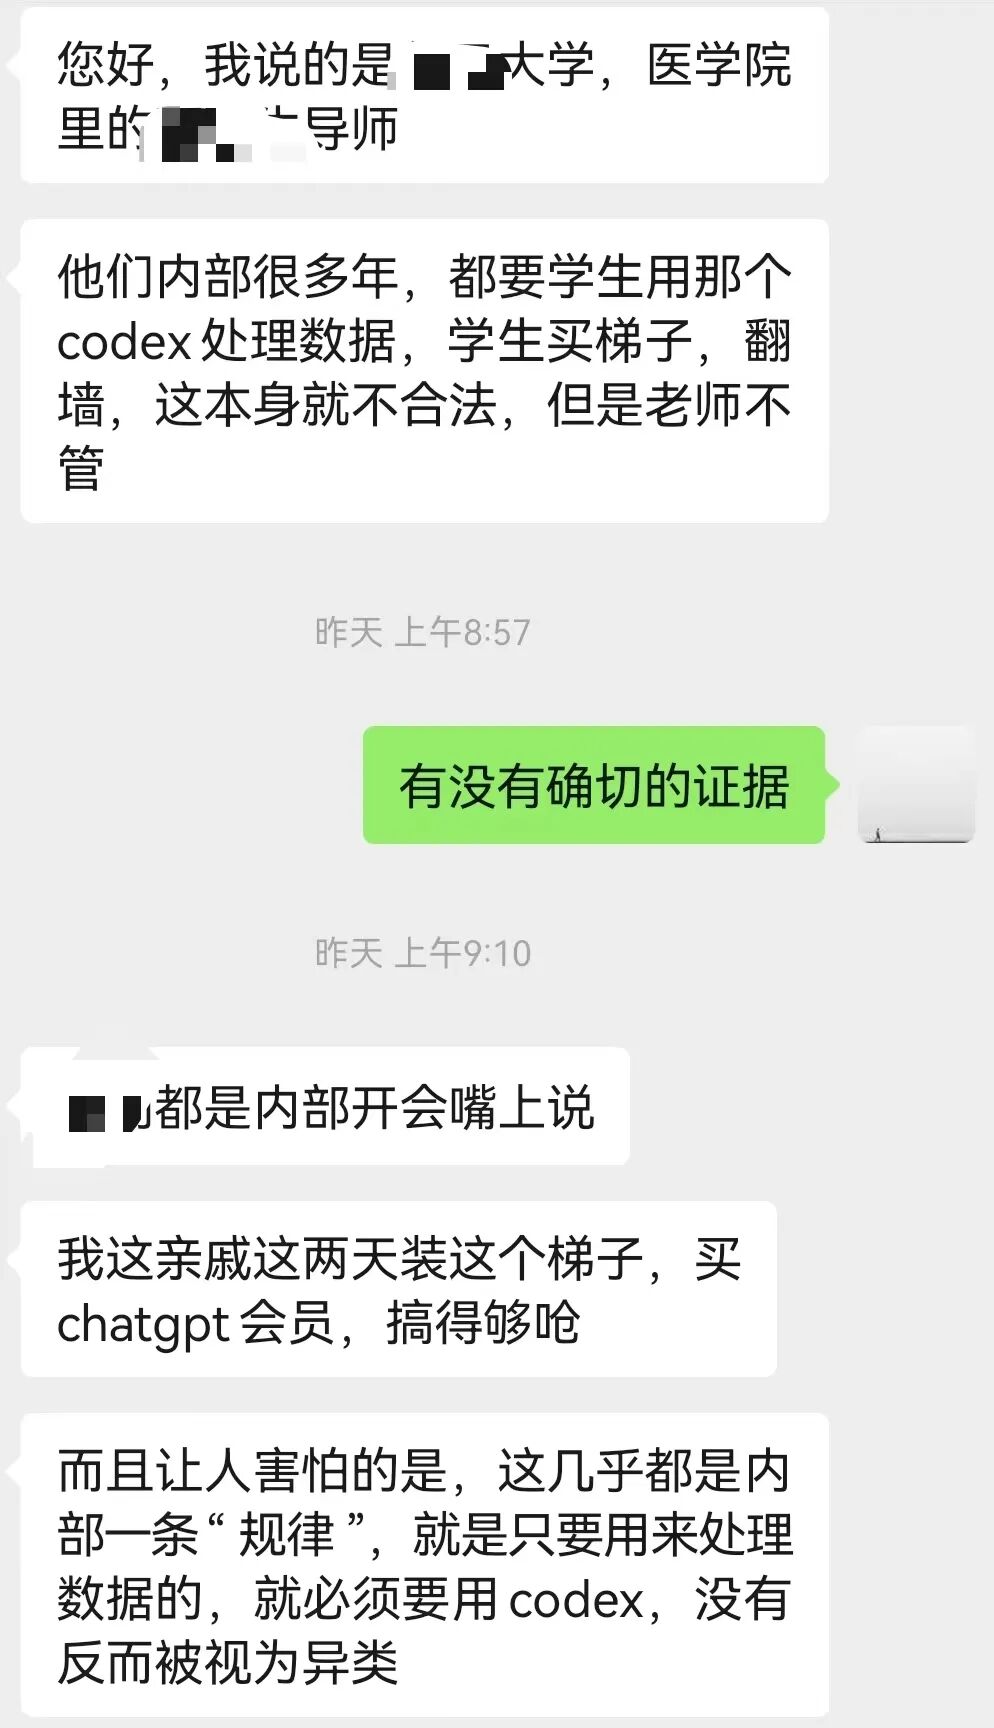
医生业内的人士告诉我:
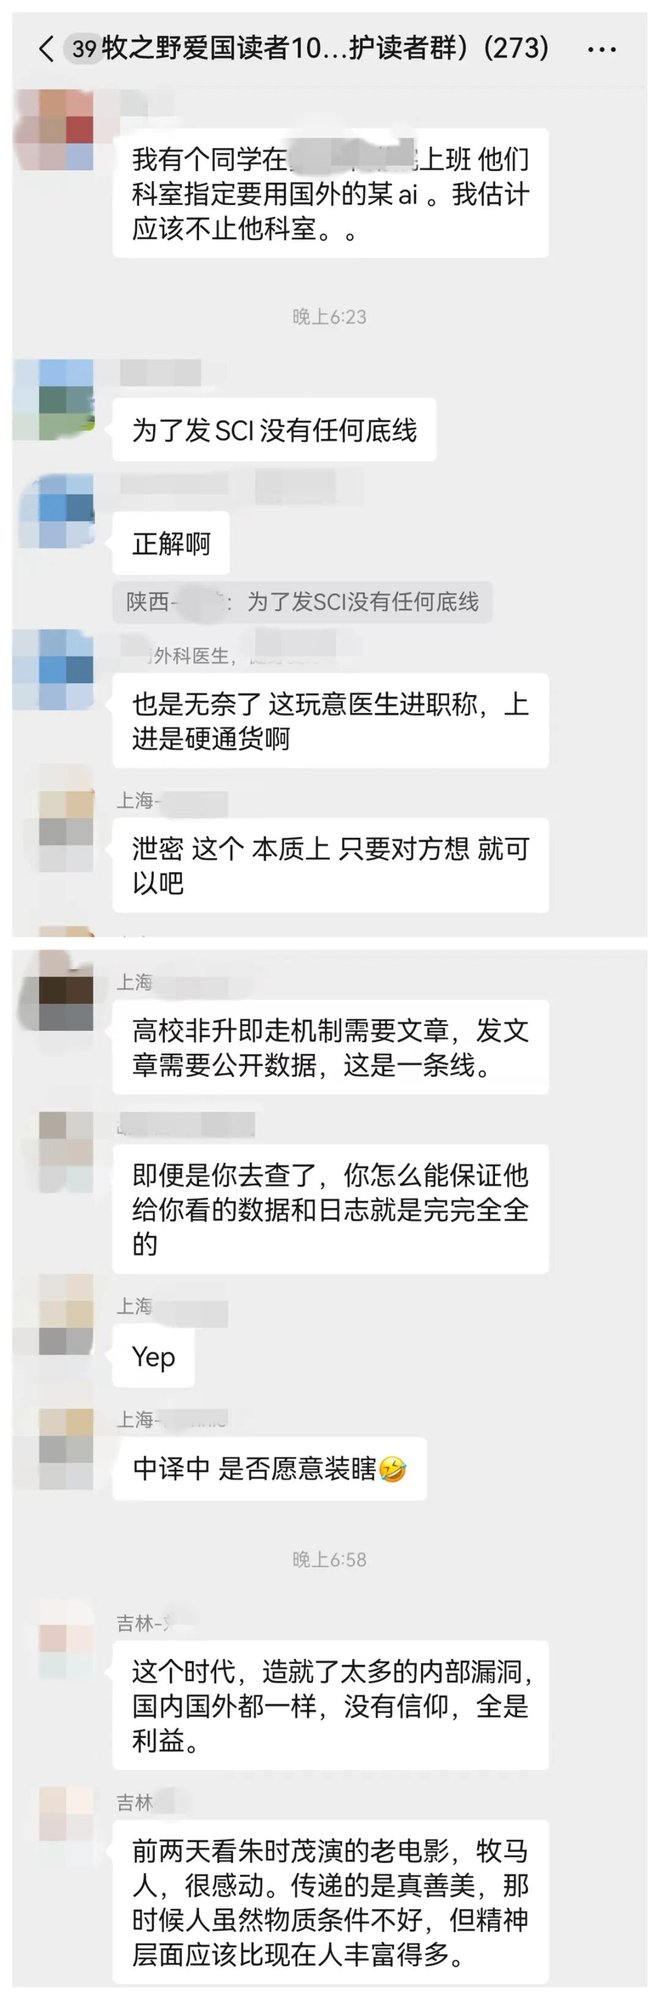
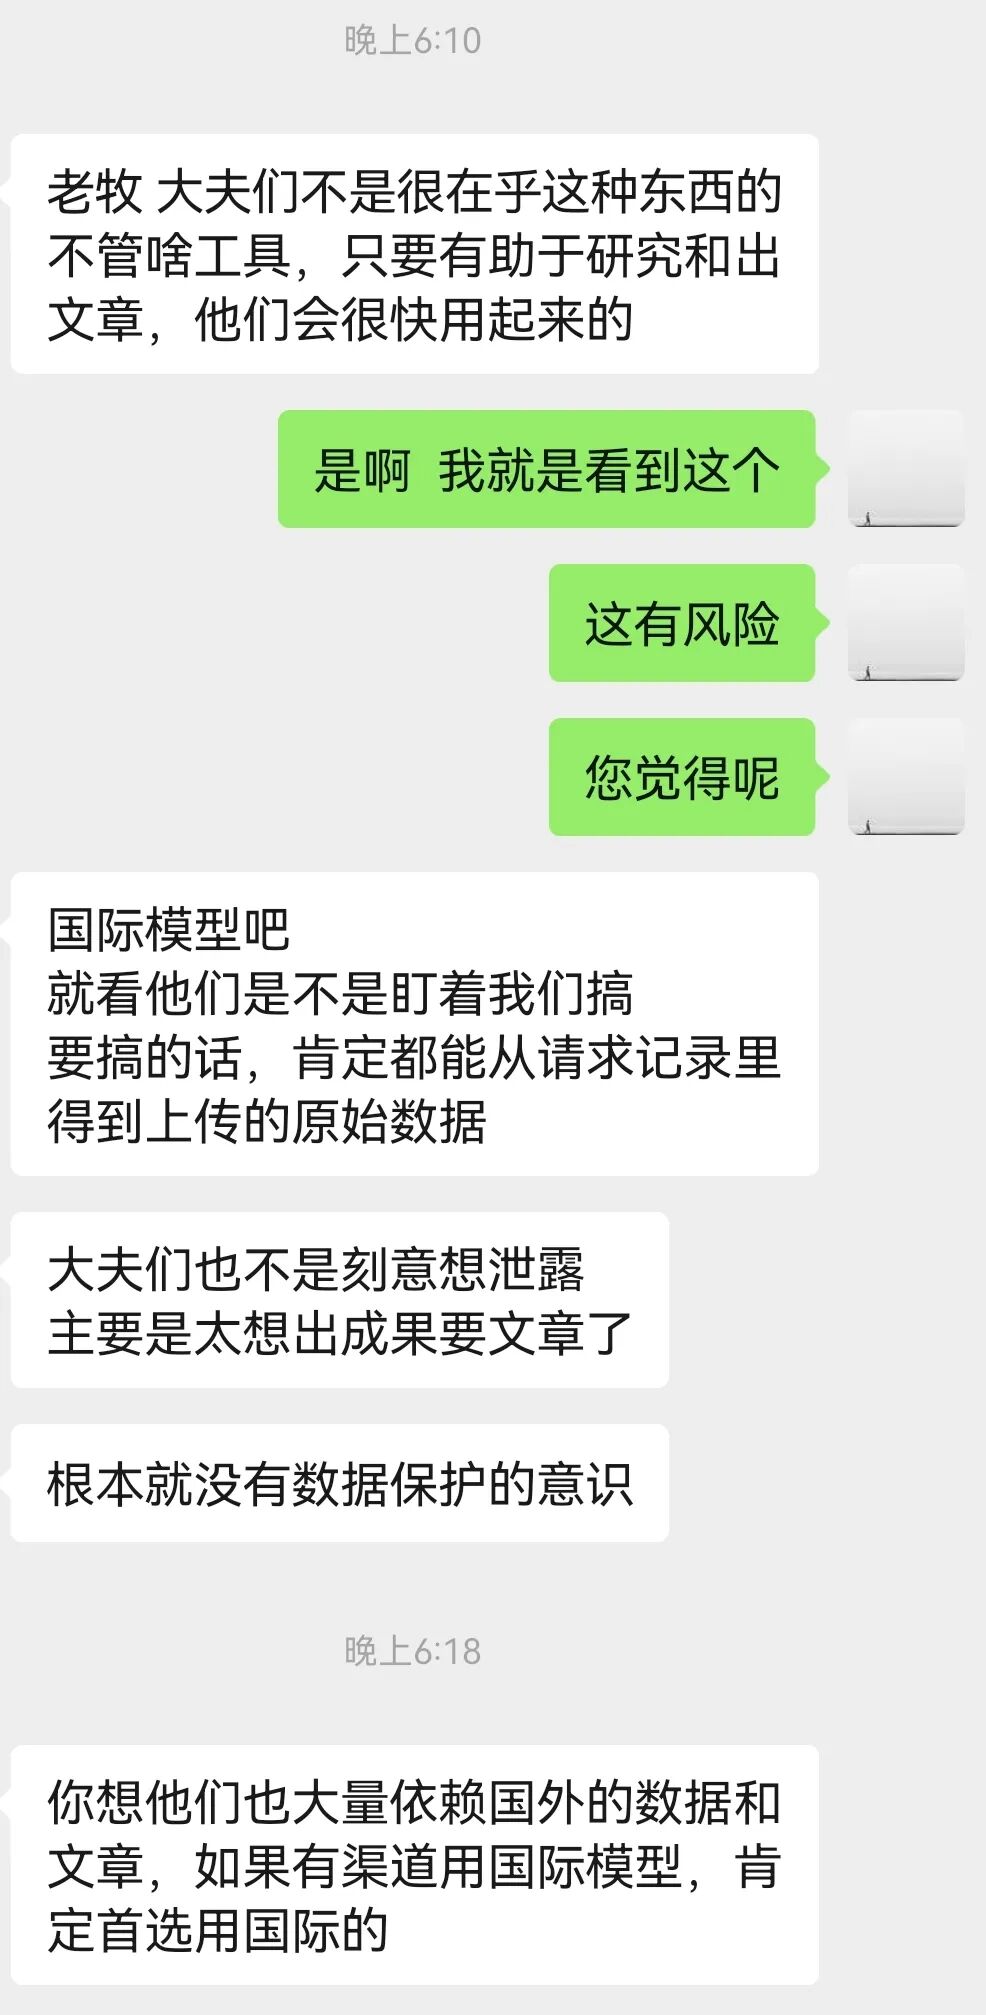
科技群的读者提供了更多信息,也提出了很好的建议:
这些信息虽然不是订密的,但同样非常有价值,是个明显的漏洞,我们应该加强对相关数据的管理,特别是科研行业。
即便是在体制内严格保密的地方,每年也有不少失泄密的案例,更不要说在这些界限模糊地方,在别人面前可能就是小透明。
再延伸一下。
为什么会出现这样的情况?
不就是因为,错误的政绩观吗?
这也看出来,AI的竞争,基本就是你死我活,谁落后,全盘皆属。
这就是为什么美国这么这么着急的原因。
希望国产AI再加把劲,希望有关部门能更加关注科研岗位数据安全问题。
也希望每一位读者,脑子里都有根弦,保守国家秘密之外,做国家数据隐私保护的第一责任人。
相关文章
-

以色列大选,内塔尼亚胡悬了?
来源微信公众号:补壹刀已获转载授权执笔/宝刀刀蜜三刀胡一刀在巴西和塞尔维亚举行大选,并且结果引起世界媒体关注之后,另一场大选可能引发的震动将影响整个中东地区,甚至更大范围。10月27日,以色列将迎来关键的第26届议会选举。这是自2023年1...
2026-10-27 09:56:04 内塔尼亚胡以色列特朗普 -

这是一个值得关注的漏洞
来源:牧之野有读者向我反映一个问题。我觉得很重要。为了验证相关信息,我这两天重点在科技群、医生群做调研,也找了一些专家朋友了解情况。重点是关于:1.如果使用国外大模型,是否存在科研信息数据(非严格涉密内容)被后台盗窃的可能2.在医学领域,这...
2026-10-27 09:55:04 OpenAI克马斯特巴克 -

给鸡打激素亏钱,因此不可能存在
原创:一棵青木来源公众号:远方青木已获转载授权农村的土鸡要养到5斤大小起码要半年,但现代养殖场里的白羽鸡却只要40天,而且其中21天都是育雏期,真正体重爆发只有十几天,速度快的让人不可思议。因此诞生了这些鸡都是打激素长大的谣言,还有人P了个...
2026-10-27 09:54:01 白羽激素鸡肉 -

-

革命老区法国,正上演最靓丽的风景线,而不是革命
作者:学爸蛋总来源:超级学爸(ID:chinasuperdad)说法国是革命老区,是有历史依据的。1789年爆发的法国大革命,号称是世界上最彻底、最轰烈的资产阶级革命,给全世界打了个样。从国际共产主义运动的角度来看,法国也是革命老区,最早的...
2026-10-27 09:51:07 法国革命巴黎 -

今天,以色列要彻底走向疯狂,中东将更加混乱
作者:坏土豆来源:一个坏土豆(ID:iamhtd)就在今天,以色列要彻底走向疯狂,而整个中东也将更加混乱。因为以色列开始大选了。其实最近的几个月,以色列的国会已经解散了,内塔尼亚胡现在仅仅只是临时看守总理,只能处理日常行政事务。所以这段时间...
2026-10-27 09:47:41 以色列政党席位 -

TVB恋综!空调清洗工获4大女星青睐争夺,梁超怡电眼狂撩,陈星妤御姐魅力
由金牌媒人林盛斌主持的TVB恋综《女神配对计划2》,昨晚第八集继续进行“心跳电话亭”环节。12位男嘉宾将争夺与何沛珈、陈若思、郭珮文、梁超怡及陈星妤在电话亭中的15分钟单独相处时间。至于女神们,则可自由选择任何一位进入电话亭,相当刺激。梁超...
2026-10-27 09:47:37 梁超怡方智弘陈星妤 -

【异动】什么信号?A500指数ETF首次加入!A500ETF招商(560610)获得主力连买4日,年内超6.5亿
10月26日,A股宽基ETF再度集体放量。截至收盘,中证A500跌0.46%,A500ETF招商(560610)获资金连续4日净流入,累计约6800万元,年初以来累计净流入超6.5亿元。消息面上,10月26日A股宽基ETF再度集体放量,A5...
2026-10-27 09:47:13 ETF指数招商 -

30万的房抢了81轮?评估45万的三室两厅,捡漏还是坑?
河南新乡有个事儿挺有意思。红旗区法院处置振中路桂竹花园二期一套房子,三室两厅两卫,二拍起拍价25.284万,评估价45.15万,相当于六折都不到就挂出来了。按说这种价格,该有人抢着捡漏吧?还真被抢了,不过过程跟"捡漏"俩字不太沾边。4个人报...
2026-10-27 09:46:50 新乡桂竹卧室 -

一家人都是美籍,但还在国内“捞金”,年赚4亿,账上还留着130亿
本文信源来自权威报道:【网易科技、澎湃新闻、界面新闻、企业观察】等(详细信源附在文章末尾)为提升文章阅读感,细节可能存在润色,文章内容皆为小编个人看法,请理智阅读,如有错误信息还请私信指出。编辑丨ZYJ前言巅峰时,这家人一年从中国市场卷走4...
2026-10-27 09:46:24 美国隔膜云南


