算力的墙与算法的光:中国AI如何撬动国运!
作者:猫哥
本文由公众号猫哥的视界(ID:maogeshijue)授权转载。
最近几天,大家都吃英伟达黄仁勋的瓜了吧?
美国媒体说的一个比一个玄乎,什么美女色诱黄仁勋,什么情报部门秘密调查一年,什么特朗普包庇等等。
其实吧,哪有那么邪乎,这个事在算力圈子里,根本不是啥秘密。
说白了,就是国内企业想要高算力芯片,黄仁勋也想卖高算力芯片,但是不能直接交易,于是一些大聪明就开始玩起了“洗澡卡”的买卖。
先在新加坡注册个皮包公司,把卡买过来,然后通过各种渠道走私回国内,这次的女主就是干这个的。
干这个的原因也很简单,太赚钱了!
一个英伟达B300,美国卖400万人民币,运到中国,就能卖2100万人民币,而且还非常抢手。
为什么差价这么大?
因为美国的芯片禁令。
2022年10月,美国商务部一纸禁令,把当时最先进的A100和H100显卡挡在了中国门外。
从此,一发不可收拾。
先是禁了特供中国的A800和H800。后来放出个性能大幅缩水的H20,也是饥饿营销。
到了2025年8月,美国政府甚至要求英伟达必须上交15%的对华营收分成才给发许可证。
再往后,连H200和AMD的MI325X也改成了逐案审批,额外加征25%的关税,还要求卖给中国的数量不能超过美国本土的一半,必须接受第三方机构上门检测,还得把客户背景查清楚。
这根本不是做买卖,这简直是羞辱。
买不到高端算力卡,国内的大厂们就开始动脑筋“借鸡生蛋”,我把数据拉到东南亚的机房去训练。
结果今年夏天,这条路也堵死了。
5月31日,美国发了个新规:只要你的公司总部设在中国,哪怕你的子公司注册在新加坡,想买先进芯片照样得申请许可证。
9月份,美国抛出新规草案,准备彻底封杀中国企业去第三国远程租用算力的路子,逼着全球的云服务商查中国客户的户口。
美国人,玩得太狠了,他们的企图很清楚:
AI是新一代“工业母机”,谁掌握算力,谁就掌握智能主权。
你不能有自己的母机,就只能买我的云服务、用我的闭源模型、按我的Token交税。
说实话,在2025年之前,中国科技圈其实弥漫着一股挺丧气的味道。
大厂高管们出去开会,嘴上喊着自主创新,私底下喝酒时都在叹气。
当时的行业共识是什么?
没有十万张顶级显卡凑成的集群,根本做不出能打的通用大模型。
所有人都觉得美国人的小院高墙太厚了,撞上去只会头破血流。
直到一个叫梁文峰的年轻人,一锤头把美国人的高墙给砸碎了。
1 DS的突破
梁文锋这人,在互联网圈里是个异类。
浙大信息与电子工程系毕业,没留过学,没在硅谷大厂镀过金。
早年带着团队在成都租房搞幻方量化,靠数学模型在A股市场里赚得盆满钵满。
换别的老板,赚了上百亿早去买私人飞机、去香港买豪宅了。
他倒好,转头把钱全砸进了大模型里。
更厉害的是他的用人。
去翻翻DeepSeek的研发名单,几乎清一色是清华、北大、浙大、北航这些本土高校刚毕业没几年的硕博生,甚至还有大四的实习生。
没有那种顶着海外名校头衔、动辄要价几千万年薪的华人科学家。
就是这么一群本土青年人,在2025年1月20日扔出了DeepSeek-R1,直接把硅谷给炸翻了:
这个性能跟OpenAI最顶尖推理模型差不多的家伙,训练成本居然只要几百万美元,是美国同行的几十分之一。
于是,DeepSeek诞生即王炸,上线7天用户破亿,比当年的ChatGPT快了整整七周。
到了1月27日,恐慌情绪在美股彻底引爆,英伟达股价暴跌17%,一夜之间市值蒸发了5890亿美元。
为啥?因为投资人突然反应过来一个可怕的事实:
要是做顶尖AI根本不需要买那么多天价显卡,那英伟达的股票凭什么卖那么贵?
那么问题来了,梁文峰到底用了什么魔法?不用高端算力卡也能搞出大模型?

说白了,哪有什么魔法,不过是把“穷”字变成了一种工程习惯罢了。
美国人算力多得烧不完,写代码讲究的是大力出奇迹。
梁文锋是精打细算,每一分算力都得掰成八瓣花。
梁文峰能干成的核心,就三件事。
第一件事,绝不养闲人。
传统大模型像一家大工厂,每次回答问题,全厂几万工人全部上工。
不管这个问题是“1+1等于几”还是“帮我解哥德巴赫猜想”,所有人都要起来思考。
人越多,电费越高,成本越贵。
DeepSeek另辟蹊径,把大模型改成了医院。
你问感冒吃什么药,系统只叫醒内科医生,绝不把骨科和泌尿科的也拽出来陪聊。
这样一来,每次处理一个词,只激活1.6万亿参数里面最对口的490亿个参数,占总人数的零头都不到。
这样一来,算力的需求就大大降低了。
第二件事,把“草稿纸”省到极致。
大模型在跟你聊天的时候,脑子里得时刻记着你们前面聊了啥,这在技术上叫KV缓存(键值缓存)。
你可以把它理解成学生做数学题时铺在桌子上的草稿纸。
对话越长,草稿纸铺得越多,显卡里的显存很快就被塞爆了。
这也是为什么很多模型聊着聊着就变傻,或者干脆忘了前面说啥的原因。
硅谷怎么解决?加钱,买显存更大的显卡,换更大的草稿纸。
梁文锋团队买不起大显卡,那就只能逼着模型学会速记。
不把用户的原话一字不落地抄在草稿纸上,而是用压缩算法,只把最核心的逻辑写到草稿纸上就行。
就像高明的秘书开会,从来不按着录音笔逐字抄写,只在纸上画几个圈:“张总砍预算两成、李工嫌工期太紧”。
这招太厉害了。
V4-Pro出来的时候,直接把百万字级别的上下文窗口做成了标配。
在同样处理一百万字长文的情况下,V4消耗的计算量只有上一代V3.2的27%,而占用的草稿纸(KV缓存)更是直接压到了原来的10%。
这意味着什么?
意味着别人必须用几十万块的顶级显卡才能跑的超长文档分析,DeepSeek在普通卡上就能跑得飞起。
算力需求的成本低了,价格自然也低了。
美国OpenAI的旗舰GPT-5.5Pro,每输入一百万个词元,加权平均收费高达30美元。
DeepSeekV4-Pro刚上线时,这个价格只有0.25元人民币。
你没看错,一个是30美金,一个是两毛五人民币,中间差了整整700多倍!
谁不喜欢便宜的token啊?
不出意外,大家蜂拥而至,跟硅谷那帮动辄几十美金的大模型比起来,Deepseek太香了好么?
第三件事:不走别人的路。
2026年4月中旬,黄仁勋在接受采访时,说了个观点。
说如果有一天,DeepSeek发布新模型时首先是在华为的芯片上跑通的,那对美国来说将是一个“可怕的结果”。
不得不说,老黄真是个美国人的乌鸦嘴。
10天后,DeepSeek-V4正式开源发布,把英伟达的GPU和华为昇腾的NPU,并排写进了同一份硬件验证清单!
也就是说,DeepSeek-V4可以运行在国产芯片上了!
外行看热闹,觉得这不就是做个软件兼容嘛。
但在内行眼里,这无异于开天辟地。
过去十几年,全世界搞人工智能的人,本质上都在给英伟达打工。
为什么?因为英伟达不仅卖显卡,它还建了一个叫CUDA的独门生态。
全世界所有的AI算法、开源库、调试工具,全是根据CUDA的规则写的。
国产芯片以前为什么难用?你造出了芯片,但你没有软件生态,谁会用呢?
开发者把现成的模型往国产卡上一搬,到处报错、死机、算力掉一半,谁用谁骂娘。
所以早年间,哪怕是华为昇腾,在DeepSeek这里也只是个替补队员。
但到了2026年,时代变了!
华为的昇腾950PR推理芯片,问世了!
采购价只有英伟达H200的三分之一到四分之一,而单卡算力比英伟达卖给中国的特供版H20高出了2.87倍!
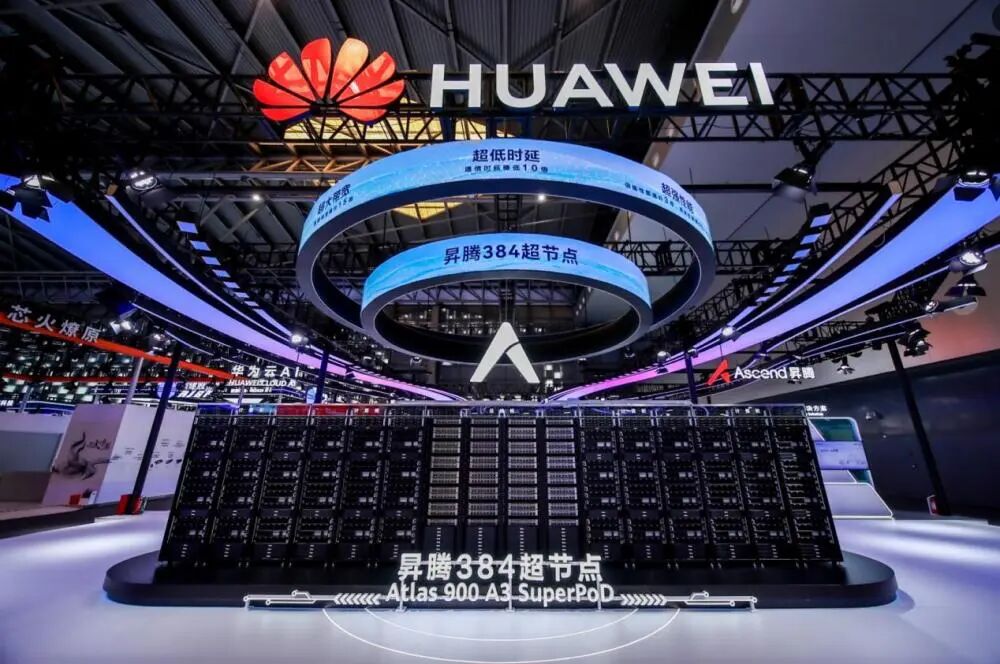
然后,配备144GB大内存、能把8192张卡连成一台超级计算机的昇腾950DT和Atlas950超节点也端了上来。
梁文锋评估后,认为昇腾950超节点在性能和价格上,完全可以平替英伟达的GB200和GB300。
话虽这么说,但首先要解决的还是生态问题——重写底层代码。
从2026年春天开始,华为昇腾的核心研发团队长年驻扎在杭州,跟DeepSeek的工程师同吃同住,在V4阶段把底层的算子一行行重新抠、重新定制。
到了9月30日国庆节前夜,DeepSeek正式向全世界开源面向昇腾平台的全套底层组件,包括TileLang编译工具、高性能计算库和分布式通信库。
DeepSeek告诉全行业,他们训练模型用到的每一个算子,现在在华为昇腾上都有了跑满硬件极限的对应版本。
这不是简单的适配,这是重塑底座了!
解决了生态的问题,剩下的就好说了。
DeepSeek在内蒙古乌兰察布的草原上,规划了一座功率高达1吉瓦(100万千瓦,相当于一个大型核电机组)的超级智算中心,一口气向华为下了16万颗昇腾950DT芯片的订单。
根据梁文峰的规划,DeepSeek的下一代旗舰大模型V5,将第一次彻底甩开英伟达,原生建立在华为昇腾950芯片集群之上!
彻底抛开英伟达生态!看明白了吗?
从“借别人的路跑别人的车”,到“借别人的路跑自己的车”,再到“修自己的路跑自己的车”,中国AI在被制裁得最狠日子里,硬生生把国产算力的任督二脉给打通了。
这像极了上世纪六十年代中国搞“两弹一星”。
当年苏联撤走专家、带走图纸,连造原子弹用的高能炸药都不给。
咱们的科学家没条件造大型风洞,就拿算盘珠子噼里啪啦打出成吨的数据;没有现成的萃取剂,就去农村收玉米芯自己提炼。
技术的突破,从来不是躺在温室里喝着咖啡想出来的,全是被绝境逼出来的。
2 国产组队
DeepSeek这一锤子砸下去,惊醒的不仅是美国人,还有中国人。
说实话,前两年,国内AI圈的风气很歪。
大家不敢碰最难的底层架构,全在应用层搞内卷、互相挖墙脚、买水军刷榜单,或者套个国外开源模型的壳子去骗地方政府的补贴。
梁文峰最可贵之处就在于,用他的Deepseek,替全中国所有的科技公司,把拦路石给搬开了。
第一,打碎了“唯砸钱论”的迷信。
几百万美金就能训出顶级模型,说明以前不是钱不够,是算法不够好。
第二,跳过了国产算力的瓶颈。
V4直接在华为昇腾950和A3超节点上跑出了单卡4700TPS的逆天吞吐量,这就相当于告诉全行业:
别找借口说国产卡不能用了,DeepSeek已经把路蹚平了,你们直接往上冲就行!
第三,技术共享。
从思维链、推理框架到算子写法,DeepSeek全都公开。
同行不用再从零开始造轮子,直接站在DeepSeek的肩膀上改代码。
这三块石头一搬开,国内科技圈的想法一夜之间全变了。
大厂们那些遮遮掩掩的野心,被彻底逼了出来,原本一潭死水的内卷,瞬间变成了热火朝天的“技术接力赛”。
月之暗面在做Kimi大模型的时候,先一步验证了Muon优化器在超长文本里的威力,梁文锋团队一看这东西好使,不丢人,直接用上了,还在论文里大方承认。
反过来,Kimi在迭代K2、K3的时候,也毫不客气地吸收了DeepSeek的注意力压缩机制。
前面探路的雷被排掉了,后面的人直接踩着脚印往前冲,这样一来,中国AI迭代的速度被大大加快了。
还有国产芯片,也一起翻了身。
2026年1月,智谱AI发布GLM-Image,全训练流程没有用一张美国显卡,百分之百跑在华为昇腾Atlas800T设备和昇腾框架。
然后是美团,宣布自家的LongCat-2.0万亿参数大模型,已经在五万张国产算力卡组成的集群上,跑通了从零预训练到推理的全流程!
根据IDC统计报告,2026年上半年,中国数据中心AI芯片市场里,英伟达的出货量同比暴跌了44%,市场份额从一年前的55%以上,一路缩水到了34%。
华为昇腾一家的出货量就冲到了57.2万颗,拿下了28%的江山,跟英伟达的差距只剩下不到6个百分点!
后面还有壁仞科技刚刚点亮的BR20X芯片、东方算芯准备年底推出的DF2000,全都剑指英伟达!
这个势头,连资本市场都有所体现了。
早些年,中国搞硬科技的创业者去融资,见的大多是美元基金的买办,人家开口闭口就是硅谷有什么对标公司。
DeepSeek启动第二轮融资的时候,你去看看抢破头挤进来的都是些什么人?
除了国家人工智能发展基金、中国移动、中信证券、腾讯和宁德时代这些巨头之外,居然还有朱一明。
朱一明是谁?
中国最大存储芯片厂长鑫存储的董事长、兆易创新的掌门人,手下管着专门投半导体设备的石溪资本。
大模型吃算力,算力卡最缺的就是高带宽内存HBM和DRAM存储。
早在2026年7月长鑫上市的时候,梁文锋就动用了194只基金产品去参与打新,砸了1.75个亿,首日账面就浮盈超过8个亿。
到了10月份,朱一明反手就把钱投进了DeepSeek的B轮融资里。
看懂了吗?
造内存的芯片大佬去投做大模型的算法天才,做算法的天才去二级市场力挺造芯片的实业家。
相互提携,共同进步。
最绝的是梁文锋给投资人立的规矩:
所有机构的钱必须打进他个人控制的合伙企业,投资人一律没有投票权,资金死死锁定五年!
他为什么这么霸道?因为他太清楚传统风投那帮人有多短视了。
如果不把方向盘焊死,明天资本就会逼着他去搞直播带货、去接垃圾广告变现,那去乌兰察布啃16万张国产卡的硬骨头就没人干了。
你看懂这盘大棋了吗?
美国人原本想用芯片禁令把中国的AI掐死在摇篮里,结果他们成了中国半导体产业最大的“媒婆”和“监工”。
他们硬生生逼着中国的顶尖算法团队、国产算力芯片厂、国产高带宽内存厂和机器人产业,放下了所有的门户之见,站在了一起。
在一起,才是中国AI。
3 坚固的脊梁
其实很多人有个疑问:梁文锋费尽心血、烧了那么多钱训出来的顶级模型,为什么要开源?
留着自己闭源收费,像OpenAI那样躺着赚美金不好吗?
如果你也这么想,那说明你格局小了。
咱们得先搞清楚一个基本事实:在生态位上,美国是守擂的庄家,中国是攻擂的挑战者。
当OpenAI和谷歌已经靠先发优势建立起闭源收费帝国的时候,如果中国企业也跟着搞闭源收费,会发生什么?
全世界一定会想:既然都要交钱,我为什么不用名气更大、生态更成熟的美国模型,而要去买你一个被制裁的中国公司的服务呢?
跟庄家按庄家的规矩打牌,挑战者永远是死路一条。
唯一的破局办法,就是把牌桌掀了!
DeepSeek把全套模型和工具链彻底开源,这就是AI版的“农村包围城市”。
你OpenAI不是想靠闭源模型向全世界收智商税吗?你华尔街不是指望靠订阅费来填补买卡窟窿吗?
好,我现在把跟你的GPT性能差不多的模型,直接免费放到网上,任何人下载下来就能在本地电脑和服务器上跑。
这一招直接打在了硅谷的七寸上。
如果免费的开源模型就能干95%的活,谁还愿意每年花几百万美金去买你的闭源接口?
当OpenAI和谷歌收不上来订阅费,他们怎么向华尔街交代那几千亿美金的算力投入?
开源,就是釜底抽薪,就是用中国的工程效率,去刺破美国科技股的金融泡沫!
但这一招真正最狠的后劲,其实是在广大发展中国家。
咱们把眼光放远一点。
在2024年前后,中小国家在AI面前是极其绝望的。
他们没钱、没电、没显卡,自己根本训不出模型。
如果去用硅谷的闭源服务,订阅费贵不说,更可怕的是国家主权也裸奔了,法院卷宗、金融流水、石油数据,全都要到美国服务器上走一遍。
哪天美国看你不顺眼,直接就能断掉你的AI服务。
但有了中国AI,就完全不一样了。
因为DeepSeek是彻底开源的,乌干达的程序员可以把权重下载到本地服务器上,断掉外网,微调出30多种非洲部落方言的农业助手。
肯尼亚团队只花了2.5万美元,就用中国开源模型给当地法院建起了处理百万份卷宗的系统。
老挝用中国技术体系上线了他们国家历史上第一个老挝语大模型,保住了小国在数字时代的母语文化。
一夜之间,亚非拉国家,不再需要美国的AI了!
什么叫做技术平权?这就叫技术平权!
什么叫大国阳谋?这就叫阳谋!
我们没有派一兵一卒,没有逼任何一个国家签不平等条约,更没有收他们一分钱的Token税。
我们只是把AI从硅谷抢出来,变成了全人类都能免费取用的基础设施。
当整个非洲的医院、东南亚的农田、拉丁美洲的学校、中东的政务系统,底层跑的都是中国开源模型的时候,美国就算再是小院高墙,困在孤岛上的,到底是我们,还是他们自己?
美国媒体有一句话说得特别酸,但又特别准:“这些中国技术一旦被下载到本地,就立刻变成了那些国家自己的资产。”
这就叫釜底抽薪。
美国人想干的事,是在数字世界里修一座高高在上的大教堂。
只有穿红衣的主教(硅谷巨头)才能解释圣经(闭源大模型),全世界的信徒(各国企业和政府)必须跪在下面交赎罪券(API税)。
梁文锋和中国的工程师们干的事,是直接把经书翻译成大白话,连同印刷机的图纸一起,免费撒向了全世界。
让非洲的农民、东南亚的老师、拉美的法官,自己在家就能印经书、改经书。
回看人类几千年的文明史,从蔡伦改进造纸术、毕昇发明活字印刷,到后来的蒸汽机、电网、互联网,哪一次文明的大跃进,不是因为核心工具从贵族手里跌落凡间、变成人人可用的大路货?
今天,中国AI干的就是这件功德无量的事——把高高在上的神坛砸了,把AI变成全人类人人都能享受的空气和水。
说到底,科技不应该高高在上,而应该服务人民。

往格局大一点说,Deepseek真的改变了中国国运。
很多网友看爽文看惯了,一看到DeepSeek把英伟达股价干崩、看到美国企业都在用Kimi和DeepSeek,就开始激动地拍大腿:“咱们又赢麻了!咱们马上就要取代美国当霸主了!”
打住。
大国崛起,从来不搞这种盲目自嗨。
中国在AI这场世纪豪赌里突围,真正的战略目标,从来不是去当第二个美国,不是去换个位置收全世界的智商税。
我们的国运,在于成功拆掉了美国人精心布置的“唯一选项”。
你想想看,如果当年没有DeepSeek捅破窗户纸,没有华为昇腾带着一帮国产芯片兄弟死磕硬件,今天的世界会是什么样?
美国人只要把算力水龙头一拧,中国所有的数字化工厂、智慧政务、无人驾驶、金融风控,全得原地趴窝。
全世界所有想搞现代化的国家,都得乖乖跪在美国门口签不平等条约。
现在呢?因为有了中国这套“极致效率+开源免费+国产算力”的组合拳,世界上突然多出了第二个选项。
只要这个选项立在那儿,美国的技术霸权就收不上高额垄断税。
只要亚非拉的兄弟们兜里揣着中国的开源代码,美国制裁大棒就挥成了空气。
多一个选项,就是撬动地球地缘政治最大的那根杠杆!
如果把历史的长镜头拉开,你会看到中国科技界两代人之间一场惊心动魄的接力。
任正非那一代人,是顶着炮火死守阵地的“守门人”。
在那个我们一穷二白的年代,芯片、操作系统、通信协议、数据库,人家卡哪儿,他们就拿命去填哪儿的窟窿。
他们的任务是兜底,是保证中国科技的根不被美国人一刀斩断。
守门人靠的是什么?是砸锅卖铁的耐力,是哪怕浑身是血也绝不后退半步的悲壮。
到了梁文锋、杨植麟这一代80后、90后,他们变成了主动出击的“破壁者”。
你看这群年轻人的做派,身上已经没有了上一辈那种苦大仇深的沉重感。
他们面对封锁,第一反应不是抱怨“我怎么没有好显卡”,而是推了推眼镜,笑眯眯地说:“不卖就不卖呗,那我把你的算法推倒重算一遍,看看能不能省掉90%的算力。”
他们用极客的聪明绕过了硬件的高墙,用彻底的开源瓦解了巨头的封闭,再用井喷的模型生态,反过来把步履蹒跚的国产芯片一把拽上了主跑道。
上一代人的耐力,加上这一代人的胆识与灵气,两代人背靠背站在一起,这才拼出了今天中国科技最坚固的脊梁。
4 逆天而行
文章写到这儿,估计不少人已经开始热血沸腾,觉得中国AI已经把美国按在地上摩擦、马上就要赢麻了。
停!
越是这种时候,我们越要冷静。
自媒体圈子有个很不好的习惯,就是一取得点成绩就吹上天、一遇到点挫折就哭天抢地。
如果我们真以为靠一个梁文锋、靠几次开源就把美国彻底打趴下了,那就想得太简单了。
实事求是地说,中国AI,还有很多不足。
第一,从零开始的“全国产万亿级预训练”,还没交出最终答卷。
咱们前面夸了半天华为昇腾和DeepSeek的配合,但必须实事求是地承认:
国产芯片承担的绝大部分任务,依然是“推理”,也就是用训好的模型干活。
真正最吃算力、对成千上万张芯片之间通信同步要求最变态的“早期预训练”,主力依然是梁文锋早年攒下的那几万张英伟达显卡!
为什么?
因为把十几万张卡连在一起,连续跑三个月不死机、不掉线,这不光是芯片单卡性能的问题,更是网络交换、散热、编译器稳定性的大考。
乌兰察布那16万张昇腾950芯片训V5大模型,要到2027年才能见分晓。
在这张考卷真正拿满分之前,谁也不敢吹牛说我们在重工业底座上已经彻底甩开了英伟达。
第二,我们的AI底座还在美国。
无论是DeepSeek把混合专家架构抠到极致,还是把注意力机制压缩出花来,本质上依赖的,还是美国人发明的“Transformer架构”里。
但下一代AI的底座架构是什么?
如果有一天Transformer架构走到头了,那个从0到1的新大陆,我们能不能先于硅谷发现?
更别提底层的芯片设计软件、顶尖光刻机、高带宽内存的先进制程,依然被欧美日死死卡着脖子。
工程优化能帮我们打赢防守反击,但要想真正加冕王座,离不开基础科学的突破。
第三,美国人的打压。
面对我们的开源攻势,美国人已经反应过来了,既然卡不住显卡,那就开始对软件和开源社区下手。
今年,美国政府内部已经在紧锣密鼓地讨论动用《国际紧急经济权力法》,打算搞所谓的“算法长臂管辖”——
规定只要你在海外哪怕租用过一秒钟的美国GPU训练,你产出的模型权重就属于美国管辖物项,不准开源、不准传回中国!
同时,他们还在给全球开源社区施压,试图把中国企业的开源代码打上“国家安全风险”的标签,禁止西方企业和盟友下载使用。
很显然,随着民主党拿下中期选举,深圳APEC峰会和下个月迈阿密G20峰会前后,中美在AI上的博弈,随时可能掀起新的惊涛骇浪。
第四,钱。
虽然美国企业开源支出里89%给了中国模型,但在全球整个企业AI大盘子里,开源模型目前只占了13%的份额,剩下的大肥肉,依然被OpenAI和Anthropic这些闭源巨头攥在手里。
现在国内C端的服务,基本都在赔本赚吆喝。
大家注意到一个细节没有?
一向以“白菜价”著称的DeepSeek,突然搞了个峰谷价,把白天高峰期的接口价格一下子往上提了好几倍。
为什么涨价?因为实在烧不起了!
国内的老百姓早就被免费互联网惯坏了,没人愿意像美国人那样每个月掏20美金订阅。
国内的企业客户又精明得很,都在白嫖开源模型自己部署,根本不给你交多少云服务费。
靠梁文锋的量化基金输血、靠投资人的几百亿融资,能撑三年,撑不了十年。
如果中国AI不能尽快在工业制造、智能汽车、医药研发和具身机器人这些实业里跑出真正的造血能力,这场吞金兽般的技术大战,随时会有资金链绷断的风险。
所以,千万别觉得国运突围是一件简单的事。
真正的国运,是在接下来的5到8年里,咱们能不能咬紧牙关挺住,看着国产光刻机和HBM显存一点点啃下良率,看着国产超节点机房在贵州和内蒙稳稳当当地跑上三年不宕机,看着我们的开源模型在亚非拉扎下深根。
对此,我们要承认挑战,但也要充满信心。
因为我们这个民族有一股全世界独一份的特质:
从不信命,逆天而行!
愚公要移山,精卫要填海,谁敢在我们面前砌起高墙,我们就一定能拿着铁锹,给它挖开!
或许今天晚上,杭州的写字楼里,梁文锋可能还穿着那件旧T恤,和一群二十出头的中国小伙子盯着屏幕上的代码。
在东莞和上海的洁净车间里,昇腾950DT和曦云C600的晶圆正在激光下日夜流转。
在遥远的肯尼亚草原和乌干达农田里,黑皮肤的年轻人正借着中国AI发出的微光,获取杂交水稻防病的知识。
大门还没有完全推开。
但门缝里灌进来的风,已经吹得大洋彼岸坐立不安了。
相关文章
-

越南的奇葩:贩毒“轻罚”,闯红灯“重罚”!
作者:虚声来源:虚声(公众号ID:lxlong20)已获授权转载这里的轻与重,是相对于之前的力度。越南从2025年开始,摩托车闯红灯罚款为400万到600万越南盾,约合人民币1155到1732元,相当于越南普通工薪族月均收入的一半以上。...
2026-11-13 07:35:32 越南闯红灯奇葩 -

算力的墙与算法的光:中国AI如何撬动国运!
作者:猫哥本文由公众号猫哥的视界(ID:maogeshijue)授权转载。最近几天,大家都吃英伟达黄仁勋的瓜了吧?美国媒体说的一个比一个玄乎,什么美女色诱黄仁勋,什么情报部门秘密调查一年,什么特朗普包庇等等。其实吧,哪有那么邪乎,这个事在算...
2026-11-13 07:35:04 中国算力美国 -

懂王掀开美国政坛战国时代,有些人和产业注定无法善终!
来源:观雨大神经各国吃瓜群众对美国政治的关注,一般都集中在总统大选上。而懂王硬是以一己之力,把中期选举也搞成了万众瞩目的马戏表演。他刷爆流量的主要方式,就是当众秀了一把四脚朝天的惨败。2026年中期选举结束后,参众两院的多数席位尽归民主党,...
2026-11-13 07:33:40 美国硅谷数据中心 -

难怪王思聪能逍遥国外,72岁王健林正式上任,他已找到一条新退路
本文信源来自权威报道:【大皖新闻、澎湃新闻、中国房地产报、证券时报】等(详细信源附在文章末尾)为提升文章阅读感,细节可能存在润色,文章内容皆为小编个人看法,请理智阅读,如有错误信息还请私信指出。编辑:qk前言当年风光无两的首富父子,曾是全网...
2026-11-13 07:31:29 王健林王思聪万达 -

高市赴华行程敲定,专机还没落地,先收到1.07万亿的逆差数据
出门做客,得先把礼数想明白。可有的人还没登门,不琢磨带什么诚意,先打听主人会不会跟自己握手,合影站哪个位置。这就好比一个刚跟邻居吵翻的人,伤人的话一句没收回,转身又惦记人家门口的笑脸。更尴尬的是,人还没出门,自家账本先亮了红灯。外头的面子没...
2026-11-13 07:28:43 日本高市中国 -

新型诈骗?女子买 7 元早餐发现卡里 26 万没了,银行回应,警方介入
很多人心里都有一套反诈标准答案:不点陌生链接,不给陌生人验证码,不跟着骗子操作转账,就能守住卡里的钱。湖南湘潭的周女士也是这么想的,她平时防备心不轻,陌生电话不接,可疑链接不点,自认把账户安全攥得很紧。直到这天早上她出门买早餐,扫码付7块钱...
2026-11-13 07:26:58 银行诈骗手机 -

金价:大家无需再等了,如果不出意外,金价或会重走历史的老路
4000美元这道关口,最后还是没守住。北京时间11月12日9时30分许,现货黄金报3991.28美元/盎司,跌破了4000美元的整数关口。直接导火索是前一天公布的美国通胀数据:美国10月CPI环比上涨0.4%,高于路透调查经济学家预期的0....
2026-11-13 07:24:52 金价黄金历史 -

特朗普早年给拜登的信件曝光 言辞恳切引关注
拜登就职首周曾透露,前任特朗普在椭圆形办公室给他留下了一封“言辞十分恳切的信”。多年以来,拜登一直拒绝公开信件的具体内容。然而,在他的新书《PromiseMe,America》中,这封信被全文刊出。信件落款日期为2021年1月20日,信封上...
2026-11-13 07:24:03 特朗普拜登信件 -

俄美乌阿布扎比再磋商:仍存关键分歧!
俄美乌阿布扎比再磋商:仍存关键分歧!△11月10日,俄美乌三方会谈在阿布扎比举行,阿联酋副总理兼外长出席。当地时间11月11日,俄罗斯、美国和乌克兰三方在阿联酋首都阿布扎比结束了为期两天的闭门会谈。俄乌原则上同意进行新一轮大规模被俘人员交换...
2026-11-13 07:23:38 阿布扎比分歧磋商 -

累计盈利2.9亿!林海的“期货经”:先算输,再算赢!
林海,很多老期民都熟悉的基本面趋势交易者。林海在期货市场活了三十年,各类实盘大赛获奖无数。今年他在期权上有了新突破,拿下“第九届夺冠高手”期权组第一名,同时专业组位列第六。据大赛主办方统计,这几年他的参赛账户累计收益超2.9亿元。这还不包含...
2026-11-13 07:23:35 期货林海期权


