中国突然停购60万枚英伟达芯片,美国急了!
原创:天涯补刀
来源微信公众号:君莫愁
已获转载授权
在很多人的理解中,中国AI芯片的性能不如美国,再加上一些恨国党不断在网络上给大家“洗脑”,于是很多人想当然的认为我们的AI大模型的性能与美国有很大的差距。
事实完全不是这么回事!
今天,我们用最通俗易懂的话让所有人都能彻底看清这个问题。
最近,一则科技消息广为流传。外媒路透社援引知情人士说法,有约60万枚英伟达H200高端AI芯片,原本计划进入内地市场,但由于未获中方批准放行,目前滞留在香港。

然后一些美国人就急了,他们不理解:以前我们非常想买英伟达的芯片,特朗普甚至想利用这个作为谈判筹码逼迫我们在其它方面向美国让步,为什么现在芯片“送”到中国大陆家门口了,中国反而不要了呢?
其实,这个一点不难理解,因为我们早已搭建好了自主可控的国产AI算力底座,不再完全依赖英伟达。
目前国内AI算力的主力,依靠四大国产核心芯片:华为昇腾、寒武纪思元、海光DCU和百度昆仑芯,再加上壁仞、沐曦、平头哥等一众国产芯片企业补位,国内已经形成了完整的算力梯队,足以支撑全国大模型训练,以及人工智能产业落地需求。
很多人或许会疑惑:国产芯片品牌这么多,它们到底有什么区别?为什么不统一只用一种芯片?
我们举个例子,大家就明白了。
我们可以把 “训练AI大模型”,理解为 “拉超级重货”。
英伟达H200,就像是一台10吨级重型重卡,单台力量极强、速度快、稳定性高,芯片之间配合极其顺畅。单凭一颗芯片,就能搞定超高难度的AI大模型训练任务,是目前全球的性能天花板。

我们的国产芯片梯队,性能则要差些:
华为昇腾910,是目前国产性能的天花板,相当于6吨大货车。它专门负责大模型训练、超算中心、万卡集群等顶级重活,也是国产芯片里价格最高的。
寒武纪思元590,相当于5吨厢式货车。它不擅长从零训练超大模型,但在智能问答、图片识别、风控推荐、日常AI运算上,性价比极高,非常适合绝大多数普通企业。
海光DCU,相当于2.5吨通用货车。它的绝对性能不算强,但兼容性优势突出。它的底层架构早期来自 AMD 授权,后续海光完成了持续自研迭代,配套 DTK 软件栈自主开发,过去基于英伟达写的代码,大多不用大幅修改就能迁移运行,是政企、信创市场的主力。
百度昆仑芯,更像是高速短途配送车。主打快速推理、高频响应,专为互联网场景、大模型日常服务优化。
……
虽然英伟达的性能很高,但是它的价格也很贵。反之,我们的芯片性能稍差,但是价格也便宜。
最关键是:不是所有企业都需要最贵、最强的芯片。
华为昇腾定位顶级算力,只适合头部企业、国家级超算中心,用来训练万亿参数大模型。中小企业买它,完全是性能浪费。
寒武纪适配市面上90%的AI公司。大部分企业不需要自己训练大模型,只需要AI对话、内容审核、视频分析、智能推荐,寒武纪完全够用,省钱又稳定。
海光的核心价值是兼容旧生态。很多国企、老系统常年使用英伟达架构,全部重构成本极高,海光能实现平稳迁移,降低国产化替换的门槛。
百度昆仑芯,则深耕互联网高频服务场景,针对性极强。
……
国内同时扶持这么多芯片品牌,不是重复造“轮子”,而是分层匹配不同市场需求,分散供应链风险。多条技术路线并行,避免被单一技术、外部制裁锁死。
很多人一直有个误区:国产单颗芯片性能不如英伟达,我们的AI实力就远不如美国?
我们可以用“种树”来完美解释中美AI的差距与优势。
算力(芯片性能),就是 “一个人的原始干活力气”。
美国的高端芯片,相当于一个人一天能种100棵树,单兵能力极强;我们的国产单颗芯片性能弱,相当于一个人一天只能种10棵树。
单纯比单兵算力,我们确实不如美国。
那怎么追平?
第一步:堆集群算力;
美国每人每天能种100棵树,我们一个人只能种10棵,那我们上10个人,一天同样能种出100棵树。
这就是我们的集群策略:单颗芯片不行,我们就用数量和组队把总算力补齐。
那我们要几颗国产芯片,才能抵得上英伟达一颗H200?堆这么多芯片,是不是整体投入更贵?
先说结论:不能简单固定一个数字,要看是峰值纸面算力,还是真实跑大模型的有效算力。
拿现在国产主力训练卡昇腾910C举例,它峰值算力大约是英伟达H200的六成左右。只看纸面数字,大概2颗昇腾910C,纸面算力接近1颗 H200。
但这只是理论值!
英伟达厉害的地方不光是单卡算力强,还有NVLink高速互联。多卡一起训练大模型的时候,卡和卡之间传数据损耗很小,算力利用率很高。国产芯片集群互联带宽、调度损耗更大,实际干活的有效算力会打折。
放到真实的大模型训练场景,想要追上1颗H200的实际产出,一般需要3~4颗昇腾 910C。
那成本是不是更高?
确实是要高些。
第一,单颗国产芯片采购价本身比H200便宜不少,一颗H200采购价大约25万上下,昇腾910C大概十几万。想要实现和一颗H200相当的有效算力,往往需要3~4颗国产卡,硬件采购总价确实要更高些。
第二,隐性成本更高:同样的任务,国产集群芯片数量更多,配套服务器、交换机、机房、电力、运维都会增加,功耗也更大。
虽然想要达到同样的性能,我们需要花更多的钱,但国产方案的价值更多体现在供应链自主可控、不受海外出口管制约束,而不是单纯硬件采购更便宜。如果没有国产芯片,美国一制裁,你直接就停摆,有钱都没用!
怎么才能降费用?
既然硬件我们暂时还追不上,那我们就在软件上做文章。
第二步就是:算法优化。
算法,就是【更好的干活方法、更聪明的技巧】。
原本我们一个人只能种10棵树,但我们找到一种种树更快的方法,提高了效率,现在一个人能种20棵!
这下优势就出来了:以前需要10个人干完的活,现在只需要5个人就能完成。
国内最典型的代表就是DeepSeek,它就是这套高效算法路线的标杆。它依靠MoE混合专家、稀疏注意力等创新算法,大幅降低训练所需算力。
前段时间不是有新闻吗,DeepSeek-V3公开的纯算力训练成本为557.6万美元(GPT-4则高达7800万美元),远低于美国同类大模型的算力投入。
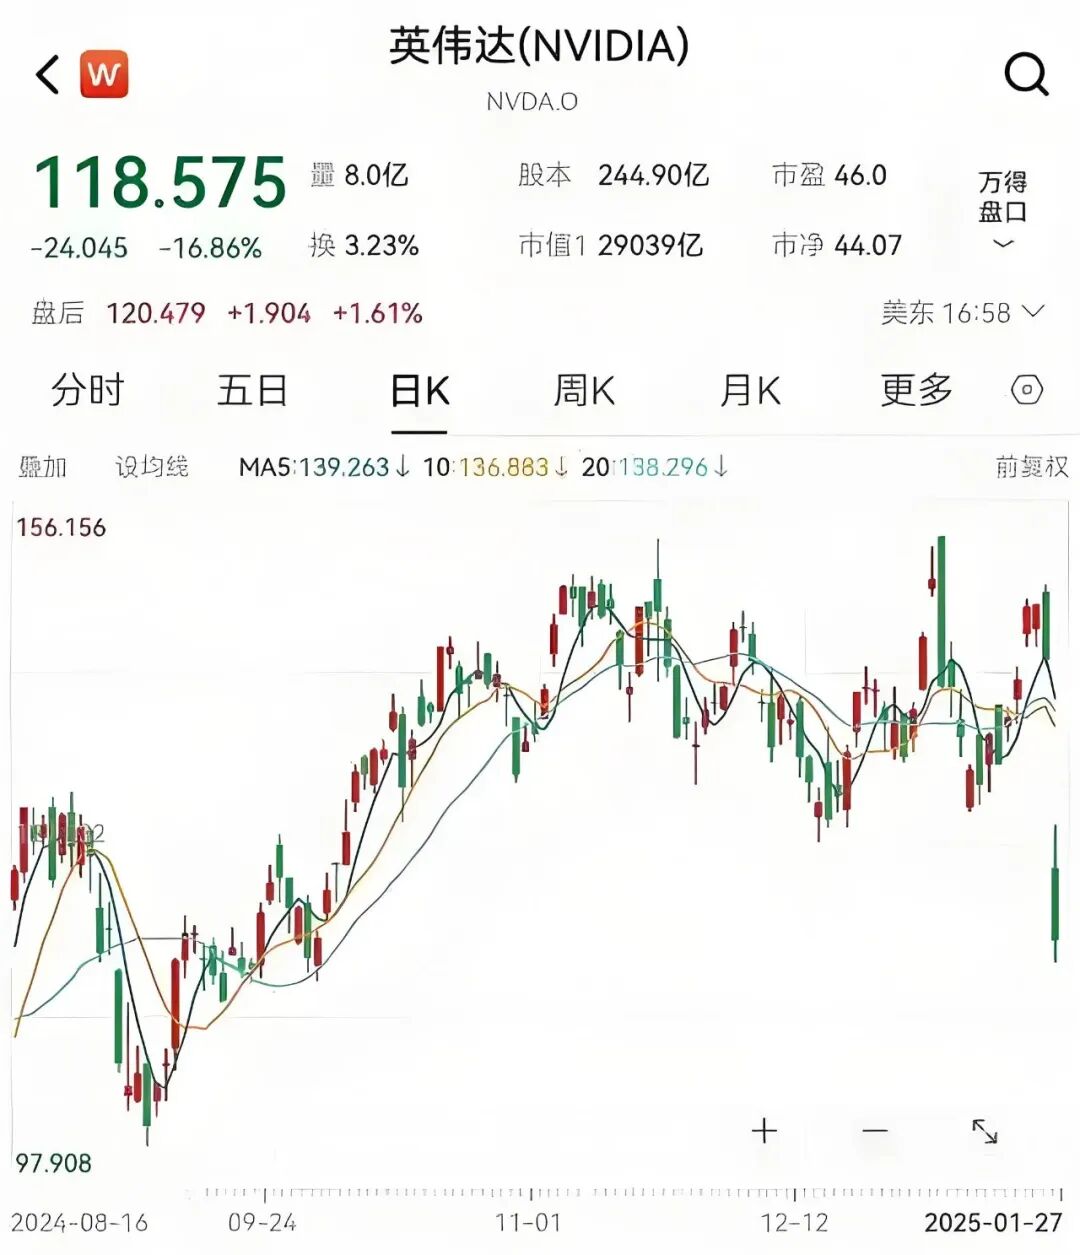
当时这个消息传开后,市场投资者担忧AI行业不再需要无限量采购高端芯片,从而引发英伟达的暴跌——2025年1月27日美股AI板块出现大幅抛售,英伟达单日跌幅约16.86%,单日市值蒸发近5900 亿美元,创下美股史上个股单日市值最大缩水纪录,这也是DeepSeek凭借算法突破震动华尔街的由来。
这也就是为什么DeepSeek这类团队的算法优化这么关键:算法把模型本身的算力需求降下来,就不用硬堆大量芯片去填差距,把长期成本打下来。
硬件是基础,算法就是用来压低这套集群的综合成本。
这就是中国AI最核心的优势:硬件单兵能力不如人,我们靠更聪明的方法补差距。
美国在高端算力硬件上优势突出,同时底层算法生态积累深厚;中国靠集群规模+极致算法优化双重补短板。
不过有一个关键点必须明白:不是芯片数量翻一倍算力就直接翻一倍,多芯片一起工作,会存在数据传输延迟、协同损耗、调度损耗。
英伟达真正的强大,不只是单卡厉害,而是它有全球最成熟的高速互联技术+几十年积累的软件生态,多卡协同损耗极低,算力利用率极高。而我们的优势,正是系统工程+智能调度+高效算法三重加持,用 “规模+调度+算法优化”,全方位抹平单卡硬件差距。
单颗打不过,集群合力+聪明算法,完全可以追得上、顶得住。
这也是人民日报明确肯定的:中国AI算力赢在系统工程,而非单颗硬件。
我们走出了独有的“以软补硬”路线:在模型稀疏化、MoE混合专家架构、长文本优化、推理提速、算力节约算法上,中国团队大量原创突破,DeepSeek就是这条路线最亮眼的代表。
别人靠更强芯片硬算,我们靠更少算力、更高效率、更聪明的算法实现同等效果。
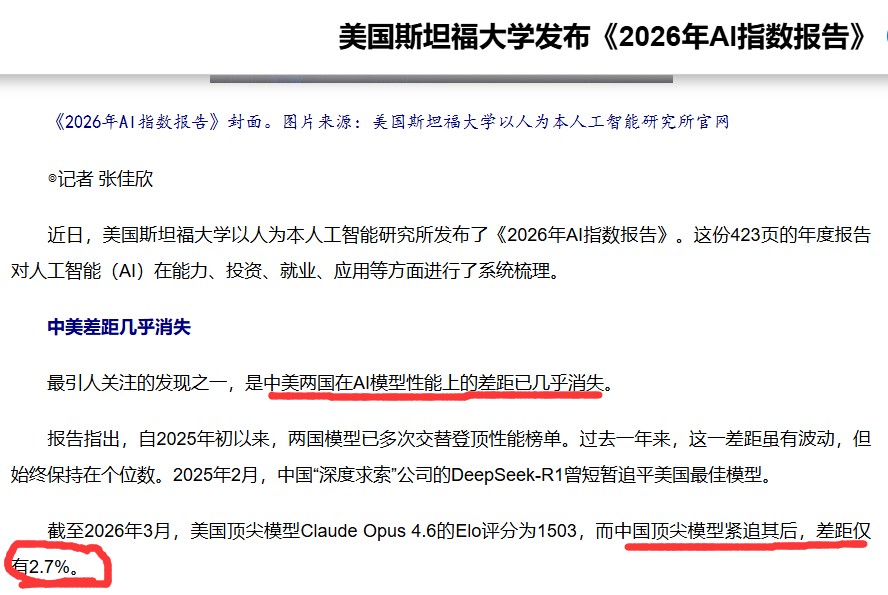
不少人应该看过相关新闻,今年4月份,斯坦福AI指数报告提到,中美顶尖大模型的性能差距只有2.7%左右。
所以,大家千万不要以为我们AI综合性能落后美国很多,虽然我们的芯片性能比美国要差,但中美AI性能差距远没有一些人想象的那么大。
美国高端单卡更强、高端算力集群更多,但靠着我们成熟的集群调度、高效算法优化能力,我们用偏弱的单颗芯片,最终跑出来的大模型实力,已经无限接近美国顶尖水平。
说到这,肯定还有人想知道:如果我们完全脱离国外技术,只依靠国内自研体系,靠集群+算法这套打法,能不能稳住身位、不被美国拉开代差?
完全可以保持在世界第一梯队!
就算彻底不用任何外国芯片,依靠国产昇腾、寒武纪、海光、昆仑芯的完整体系,配合超大算力集群调度、自研高效算法,我们依然可以持续训练、迭代、升级国产大模型,足以支撑国内所有 AI 产业、科研、商业应用持续发展。
当然了,算法优化、集群调度都是 “效率加成”,不是无限上限。如果国外下一代芯片持续大幅跃升,同时他们也持续迭代底层算法,我们只靠堆规模和算法优化追赶,未来的压力会变大。
所以国家现在是两条腿走路:
第一,靠现有国产算力+算法优化+集群调度,保证现在不掉队、能用、够用、强大;
第二,全力攻坚先进制程、芯片制造良率,补齐硬件短板,实现彻底反超。
看到这里,很多人还会追问最核心的问题:这些国产芯片,我们能不能100%完全自己生产?
这里必须分清两个概念:芯片设计和芯片制造。
在设计层面:华为、寒武纪、百度等国产AI芯片,核心架构、核心逻辑、软件栈,全部是国内自研,知识产权完全自主可控。
在制造层面:成熟工艺的推理芯片,国内已经可以完全自主量产、自给自足。
高端训练芯片,比如昇腾910,因为需要先进制程,目前暂时无法无限量大规模量产。
大家常听到的 “昇腾910良率不足”,属于行业券商调研的产业现状(非官方公布数据)。
通俗解释就是:工厂生产100颗高端芯片,因为工艺难度极大,只有一部分是合格可用的,剩下的会直接报废。这就导致高端国产芯片成本高、扩产慢。
但重点是:良率问题是制造工艺短板,不是设计短板。
我们的芯片设计水平,已经达到世界顶级,只是顶级制造设备还在攻坚突破中。
现阶段,我们的发展思路非常清晰:先用成熟国产芯片、集群组网、自研算法软件体系,把全国算力网络、大模型生态全部跑通、做强。同时持续攻坚先进制程,不断提升芯片良率,一步步实现全链条自主可控。
看到这,你就会彻底明白了,现在不是中国离不开英伟达,是英伟达离不开中国市场。
过去多年,中国市场撑起了英伟达很大一部分营收,而我们如今稳步国产化替代,对海外芯片的依赖持续降低,从被动受制变成自主可控,真正慌张的是美国芯片产业。
他们非常清楚:一旦中国完整跑通国产算力体系,全球AI芯片的垄断格局,将彻底终结。
曾经的技术制裁、芯片封锁,最终没有困住中国,反而倒逼我们补齐短板、加速全产业链崛起。
现在中美AI领域的竞争正如毛主席在《丢掉幻想,准备斗争》中所言:“多少一点困难怕什么。封锁吧,封锁十年八年,中国的一切问题都解决了。中国人死都不怕,还怕困难么?”
相关文章
-

为什么满清的口碑逐渐变差了?
作者:龙牙来源:龙牙的一座山(ID:Longyadeyizuoshan)大家可能都知道中国的电影产业嘎了,《牛来》无厘头爆火,是中国电影棺材板上一颗大大的镇魂钉。然而在无人在意的角落,中国的图书出版行业已经“黄土垄头送白骨、红烛高香泛磷光”...
2026-11-07 15:03:20 阶层士大夫中心化 -

中国突然停购60万枚英伟达芯片,美国急了!
原创:天涯补刀来源微信公众号:君莫愁已获转载授权在很多人的理解中,中国AI芯片的性能不如美国,再加上一些恨国党不断在网络上给大家“洗脑”,于是很多人想当然的认为我们的AI大模型的性能与美国有很大的差距。事实完全不是这么回事!今天,我们用最通...
2026-11-07 15:02:11 芯片算力美国 -

-

独生子女继承父母房产,还有别人的份?
作者:牲产队长来源公众号:牲产队一条法律,把不少独生子女的梦打碎了!很多独生子女都有个错觉,家里就我一个,爸妈的房子、存款,将来当然全是我的,可这个念头,被现实结结实实敲了一闷棍。先问一句,作为独生子女,你到底是不是父母唯一“第一顺序继承人...
2026-11-07 15:00:14 独生子女父母继承人 -

最坏的时候其实并没有到来
来源:牧之野这两天的情况都看见了,美国中期选举导致的全球资产震荡不是一个惨字可以概括的。我不是在这里给你们做心理按摩,因为我从来怎么看怎么说,也早就建议不是10%的人一定要远离股市,不要碰。我只是单纯分析宏观形势。你们以为股灾到了,以为美国...
2026-11-07 14:58:37 美国分析泡沫 -

比特币是欧美给中国挖的坑?可如今回头一看,最终究竟是谁在坑里
2026年11月初,比特币在7.7万美元附近徘徊。2025年10月6日,它曾冲上126080美元的历史高点。按11月4日约80405美元的报价计算,从山顶到现在已跌去近四成。2026年10月,比特币又跌了7.3%,连续第二年在10月下跌。这...
2026-11-07 14:56:01 比特储备货币 -

好日子到头了?万达9.45亿债权挂牌后,王健林近况曝光,令人唏嘘
文|九三编辑|黄毅来了当初,王健林一句“一个亿小目标”曾经震彻商界。可谁又能料到,昔日风光无限的前首富;如今连8.4亿本金都兜不住。长城资产一纸9.45亿债权挂牌公告;两座还在收租的万达广场押上赌桌。当初愿意给万达展期宽限的资管,耐心已经耗...
2026-11-07 14:53:06 万达王健林债权 -

宣告违约,千亿地产大佬崩盘
来源:不良资产头条四次登上胡润百富榜、手握两大上市平台、坐拥千亿资产的西南资本新贵戴学斌,短短两年,就从人生巅峰跌落谷底。给债权人留下了满地烂尾楼。丧失上市公司实控人地位7月7日,ST龙大(龙大美食)发布公告:公司发行的6.47亿元龙大可转...
2026-11-07 14:48:12 蓝润地产戴学斌 -

国家出手了!以后买菜、赶集、逛超市将有大变化?
国家发展改革委等5部门联合发布《关于加强消费基础设施建设促进消费投资良性互动的指导意见》,今后买菜、赶集、逛超市都将迎来一些新变化。此前,2026年8月18日,商务部等9个部门联合发布了一份文件,18条举措全部指向同一个地方:县域。过去将近...
2026-11-07 14:47:34 县域冷链建设 -

美媒曾昭告全球: 中国不偿还100年前的债务,美将不承认欠中国的钱
假如收拾老屋时,从樟木箱底翻出一张爷爷那辈写的借条,上面写着借某家大洋二十块,还按了手印。拿着它去找对方的孙子要钱,会是什么结果?多半会被人当成笑话。道理不复杂。按民法典,普通债务的诉讼时效是三年,从权利受损那天算起过了二十年,法院就不再保...
2026-11-07 14:46:30 中国美国债券


